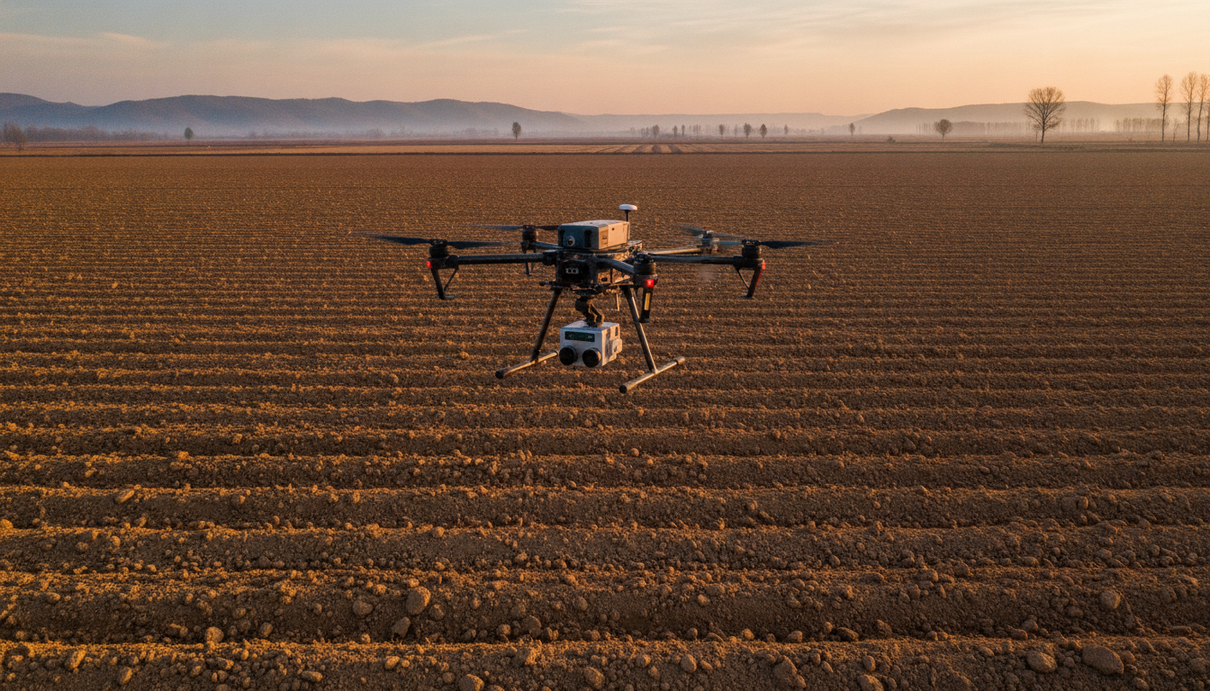
Китайские ученые разработали методику, которая позволяет с высокой точностью определять содержание органического углерода в почве с помощью дронов, даже если для калибровки оборудования имеется менее сотни лабораторных образцов. Система на основе искусственного интеллекта решает главную проблему спектрального анализа с воздуха – необходимость в большом объеме эталонных данных, сбор которых дорог и трудоемок.
Содержание органического углерода – ключевой показатель плодородия почвы и важный фактор, влияющий на климат. В почвах планеты содержится вдвое больше углерода, чем в атмосфере. Традиционный химический анализ точен, но требует много времени и ресурсов. Альтернатива – спектроскопия в видимом и ближнем инфракрасном диапазоне с беспилотника, позволяющая быстро сканировать целые поля. Однако для настройки прогностической модели обычно нужны сотни образцов почвы с известным химическим составом, что делает технологию недоступной для многих хозяйств.
Исследователи из провинции Шаньси провели эксперимент на трех сельскохозяйственных полях, собрав всего 76 образцов почвы. На основе 51 образца они обучили несколько генеративных ИИ-моделей, чтобы те создали синтетические данные и расширили обучающую выборку. Наилучшие результаты показала модель WGAN-GP (генеративно-состязательная сеть Вассерштейна с градиентным штрафом). Она повысила точность прогнозов на 13,7% по сравнению с моделями, обученными только на реальных образцах. Качество прогноза перешло из категории «приблизительного» в категорию «хорошего».
Примечательно, что WGAN-GP генерировала меньше «правдоподобных» образцов, чем другие модели, – фильтр качества проходило не более 28% синтетических данных. Однако именно эти данные оказались наиболее ценными, поскольку они заполняли пробелы в реальной выборке, а не просто копировали уже имеющуюся информацию. В то же время популярные диффузионные модели, лежащие в основе современных генераторов изображений, с задачей не справились: ни один из созданных ими образцов не прошел контроль качества.
Эксперимент также показал неэффективность использования больших внешних баз данных без адаптации. Попытка дополнить выборку тремя тысячами образцов из открытой спектральной библиотеки привела к катастрофическим результатам – модель стала работать хуже, чем без них. Это связано с тем, что данные, собранные на разных почвах и с помощью разного оборудования, могут не дополнять, а «отравлять» локальную модель.
Авторы исследования отмечают, что работа проводилась в одном регионе на одном типе почв, и для подтверждения универсальности метода нужны дальнейшие тесты. Тем не менее их подход, сочетающий конкретный тип генеративной модели, строгий отбор синтетических данных и подходящий алгоритм регрессии, может значительно удешевить и ускорить мониторинг состояния почв в сельском хозяйстве и экологии.